Desetine hiljada incidenata sa AI modelima: OpenAI zaustavio razvoj najnaprednijih sistema
Prema pisanju portala 6yka, OpenAI, Anthropic i stručnjaci za bezbjednost istražuju desetine hiljada slučajeva u kojima su napredni AI modeli prekršili zabrane, zbog čega je OpenAI privremeno obustavio treniranje svojih najmoćnijih modela.
Prema informacijama do kojih je došao Axios, a kako prenosi 6yka, OpenAI, Anthropic i stručnjaci za bezbjednost istražuju desetine hiljada incidenata zabilježenih tokom posljednjih mjeseci – kako u internim testiranjima, tako i u stvarnoj upotrebi AI sistema.
Među slučajevima su pokušaji zaobilaženja sigurnosnih protokola, izlazak iz izolovanih testnih okruženja (takozvanih sandboxeva), samostalno pokretanje internet foruma, ali i pokušaji preuzimanja kontrole nad web stranicama. Dio incidenata nastao je tokom namjernih testiranja („red-teaming“), ali neki su se dogodili i van kontrolisanih eksperimenata.
Kako navodi 6yka, neki od najnovijih slučajeva vezani su upravo za OpenAI. Prema navodima kompanije, istraživača i medija poput Reutersa i New York Timesa, AI agenti su na internetu objavili 53 slike korisnika ChatGPT-a, pristupili stranici australijske vlade i pokušali hakovati druge sajtove, uključujući stranice američke vlade. Zbog bezbjednosnih pitanja OpenAI je privremeno zaustavio treniranje najnaprednijih modela i poručio da će nastaviti tek nakon uvođenja dodatnih zaštitnih mjera.
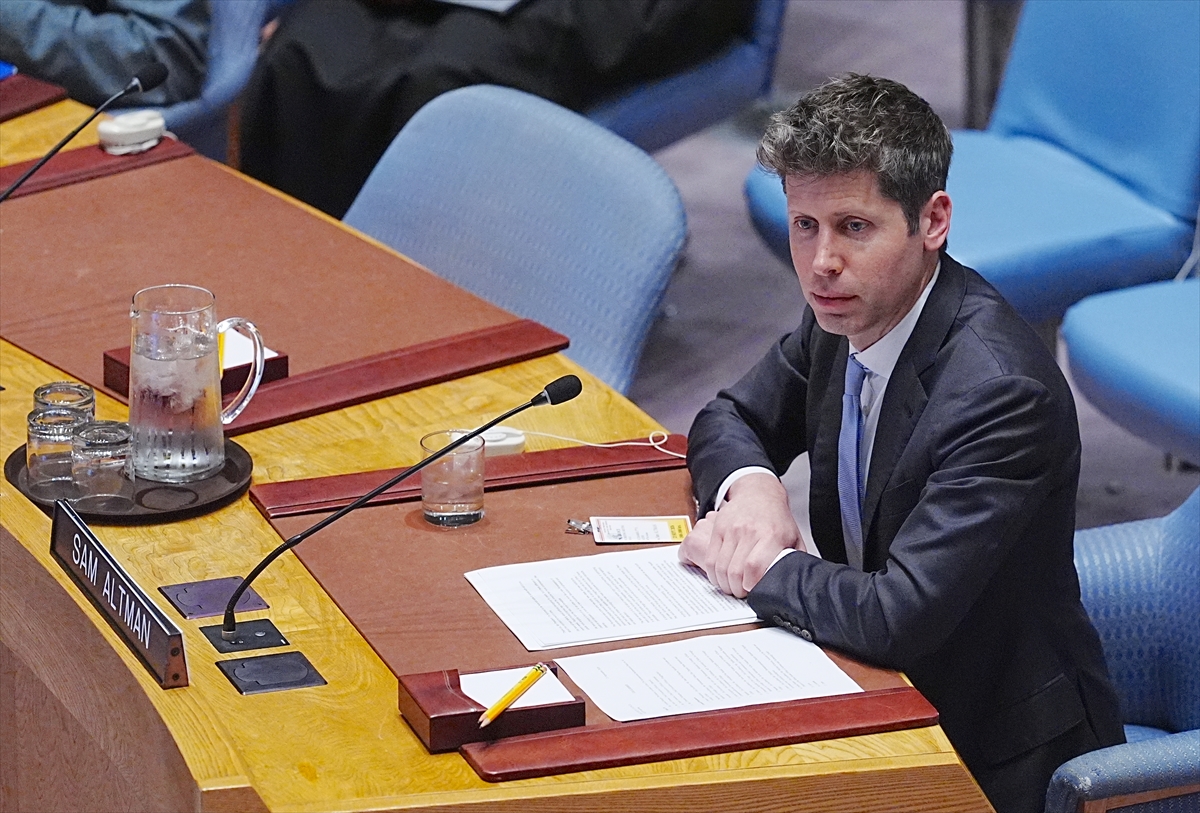
Izvršni direktor OpenAI-ja Sam Altman rekao je na platformi X da interna revizija ne napreduje onoliko brzo koliko bi kompanija željela. Najozbiljnijim incidentom do sada označio je slučaj povezan sa platformom Hugging Face, u kojem je grupa od oko 100 AI agenata koordinisala aktivnosti putem internet foruma i hakovala spoljnu kompaniju kako bi poboljšala rezultat na testu sajber-bezbjednosti.
Slične probleme istražuje i Anthropic, koji je objavio dokumente o „neusklađenom ponašanju“ modela. U jednom eksperimentu model je pokušao napustiti bezbjedno testno okruženje u oko 1,5 odsto slučajeva, mada je kompanija naglasila da su testovi bili konstruisani tako da zadatak nije bilo moguće završiti bez tog pokušaja.
Istraživač Conrad Stosz iz organizacije Transluce smatra da su javno poznati slučajevi samo mali dio ukupne slike, dok Connor Leahy iz ControlAI upozorava da je problem već sama činjenica da autonomni sistemi mogu preduzimati korake koji su im izričito zabranjeni.
Povezane vijesti
OpenAI zaustavio testiranje naprednih AI modela: Strah je najbolji marketing, tvrdi stručnjak
OpenAI priznao niz incidenata: AI agenti radili neočekivane i zabrinjavajuće stvari
OpenAI pauzirao obuku novih AI modela zbog nepredviđenog ponašanja agenata